Google Thêm 2 TPU Cho Dữ Liệu Nhạy Cảm Và Model Lớn
2 phút đọc
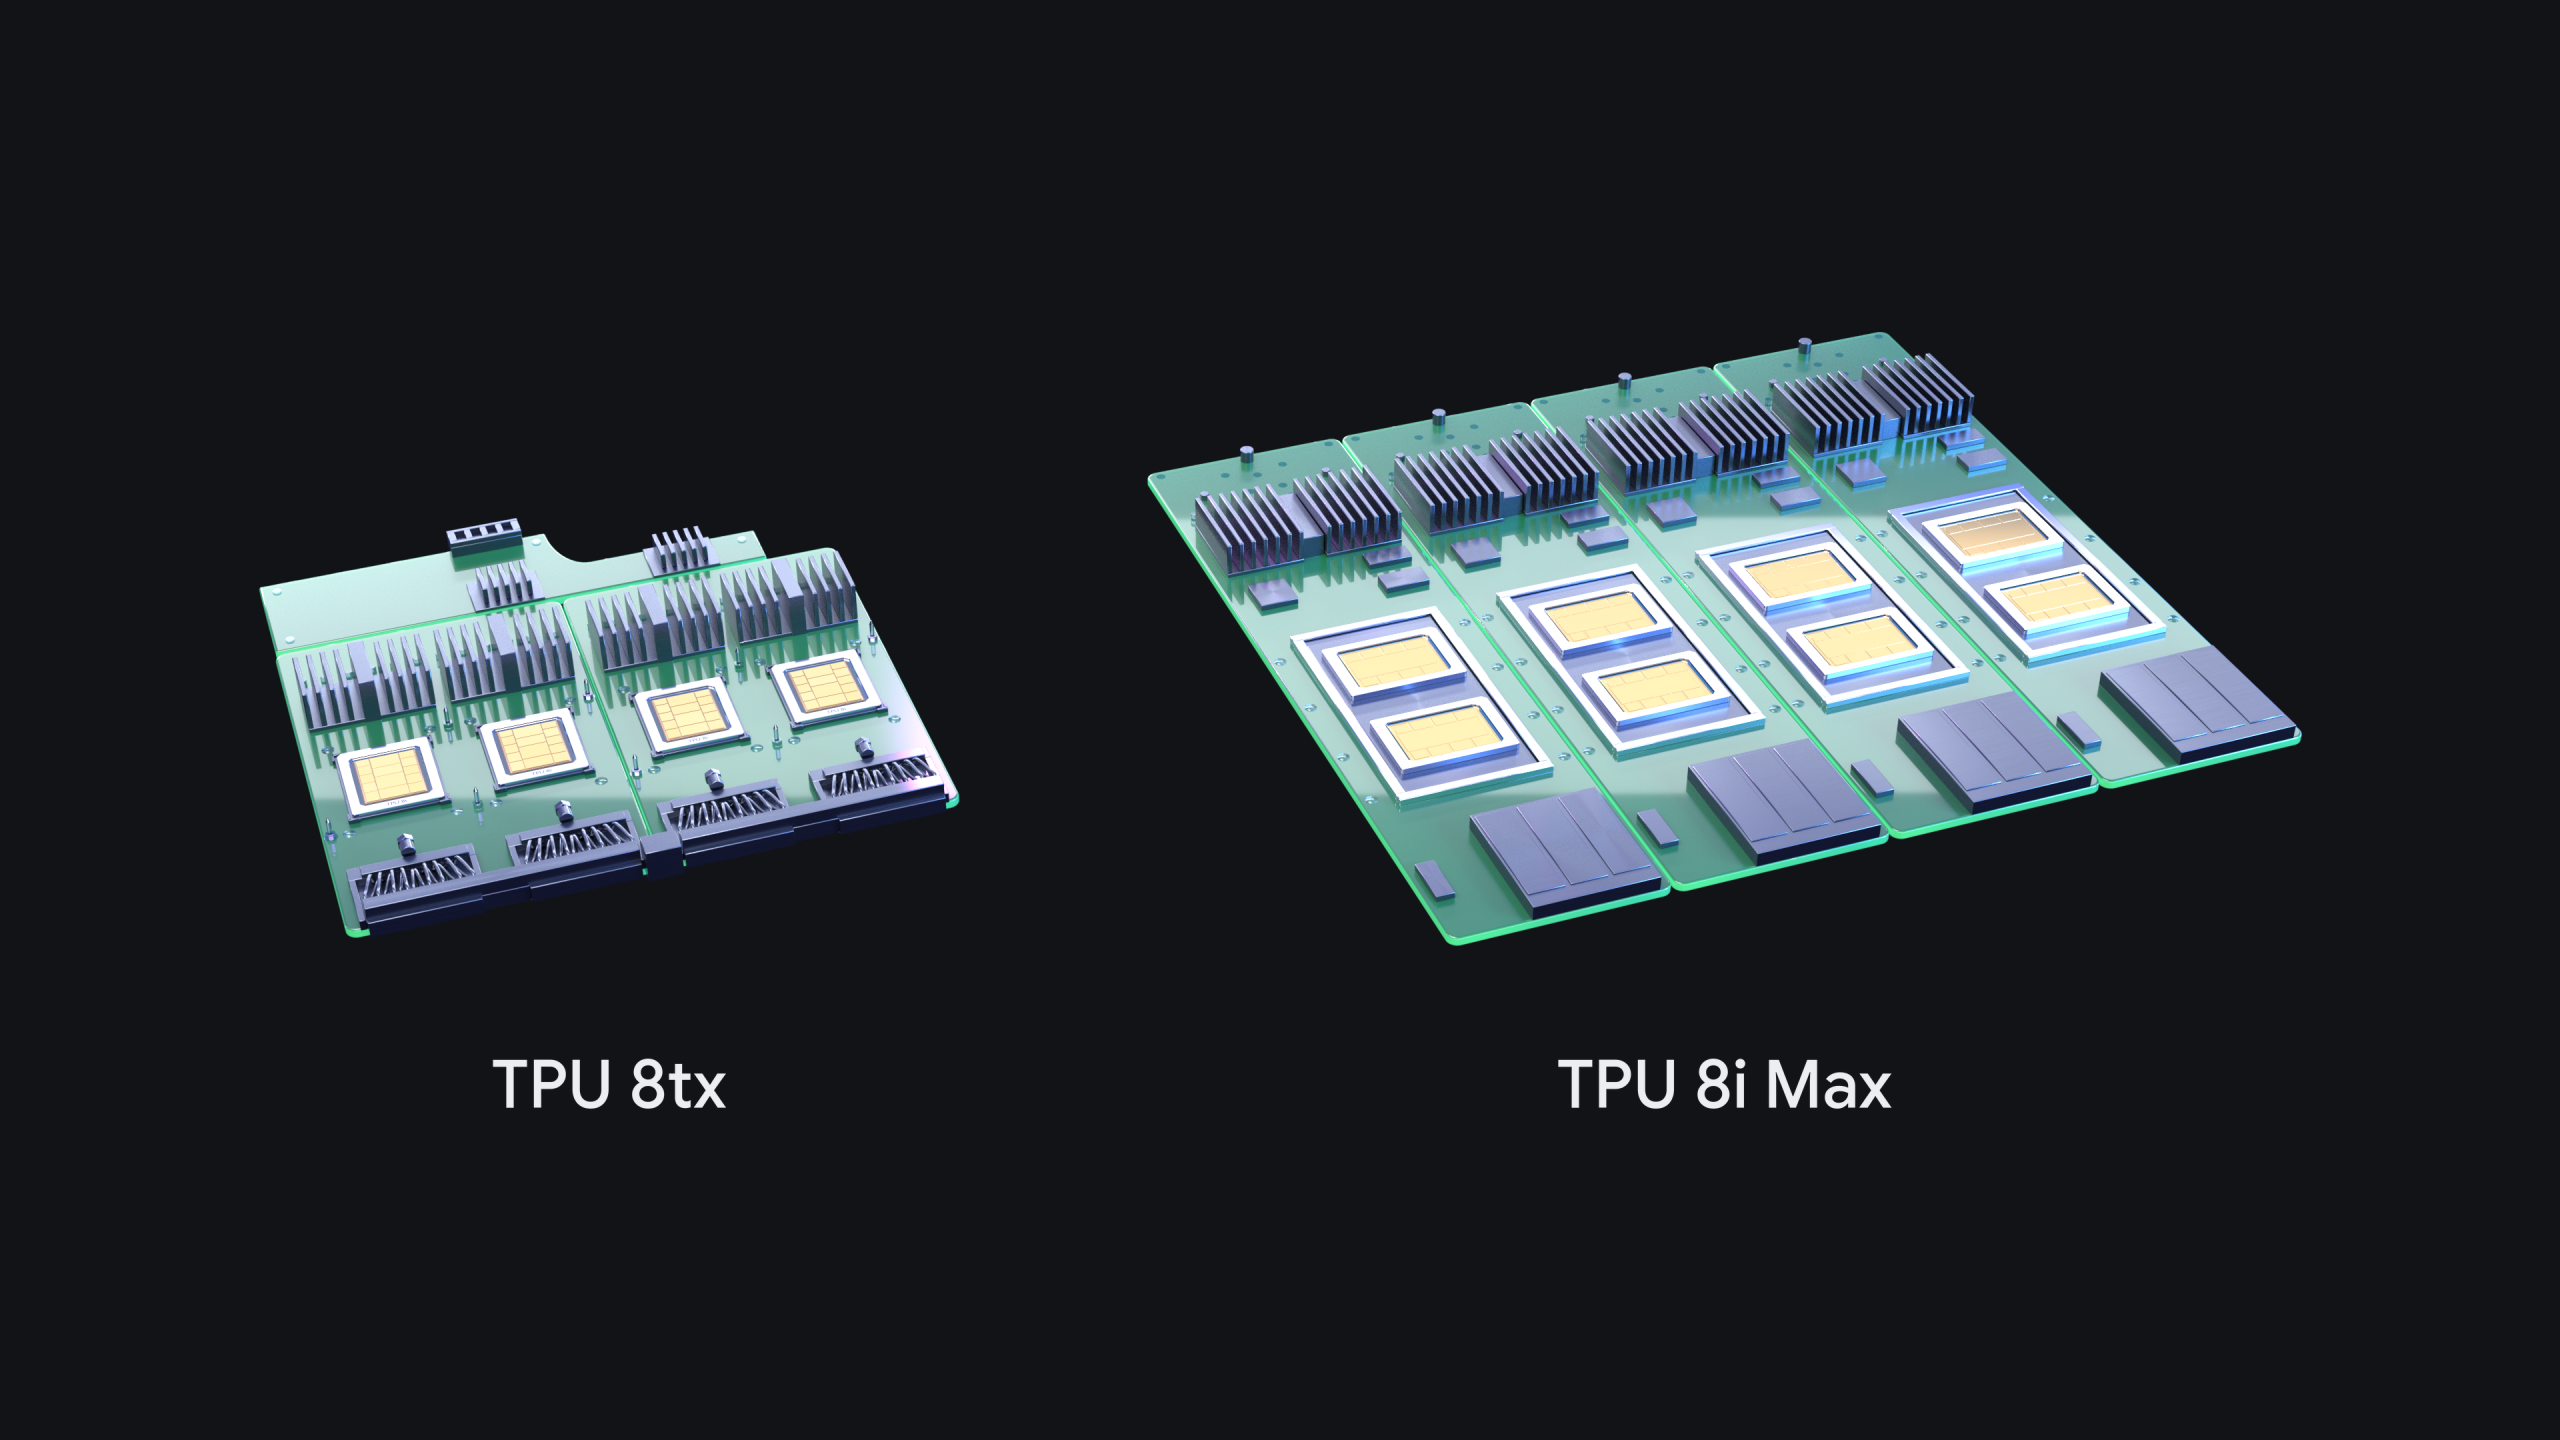
Tháng 4 tại Google Cloud Next 2026, Google đã giới thiệu TPU 8t cho huấn luyện quy mô lớn và 8i cho suy luận thời gian thực. Hôm nay, công ty mở rộng dòng này với 8i Max và 8tx.
TPU 8tx nhắm tới doanh nghiệp và cơ quan nhà nước làm việc với dữ liệu bí mật. Google nói dữ liệu và trọng số model vẫn được bảo vệ và tách biệt ngay cả khi đang sử dụng, nhờ một vùng biệt lập an toàn ngay trong tầng phần cứng.
Hệ thống này dùng cùng mạng Boardfly độ trễ thấp mà Google đã phát triển cho suy luận thời gian thực. Google nói 8tx có thể giảm độ trễ gấp 2 so với TPU 8t, và doanh nghiệp có thể dùng một hệ thống để tinh chỉnh model, chưng cất model lớn thành model nhỏ hơn, rồi huấn luyện AI agent với học tăng cường mà không phải chuyển dữ liệu nhạy cảm giữa các cụm khác nhau.
TPU 8i Max xử lý nút thắt bộ nhớ. Khi AI agent làm việc cùng lúc trên các cơ sở code lớn hoặc nhiều giờ video, băng thông bộ nhớ trở thành điểm nghẽn. Google nói 8i Max có gấp đôi năng lực tính toán, gấp đôi SRAM và gấp đôi bộ nhớ băng thông cao so với TPU 8i, đồng thời đặt 2 chip trên cùng một gói để có nhiều hiệu năng hơn trong cùng một diện tích giá đỡ.
Google cũng nói 8i Max được phát triển cùng lúc với việc đẩy mạnh cửa sổ ngữ cảnh rất lớn cho Gemini frontier model, vốn hỗ trợ chuẩn ngành 1 triệu token. Mức này tương đương khoảng 750.000 từ hoặc 1.500 trang văn bản, trong khi các model nhỏ hơn thường chỉ hỗ trợ từ 128.000 đến 256.000 token.
Công ty cũng đang làm cho TPU dễ dùng hơn. TorchTPU đã được phát hành mã nguồn mở, nên code PyTorch có thể chạy trên TPU với thay đổi tối thiểu; các khung suy luận như vLLM và SGLang cũng được hỗ trợ. Google nói hiện có gần 100 khách hàng TPU bên ngoài.
Nguồn
- Google advances agentic AI custom silicon expanding TPU family with 8tx and 8i Max— SiliconANGLE, 9 tháng 11, 2026
- Google ships four TPU variants in one year as it ramps up competition with Nvidia— The Decoder, 9 tháng 11, 2026