Google Muốn Video AI Hiểu Lúc Nào Cần Lên Tiếng
3 phút đọc
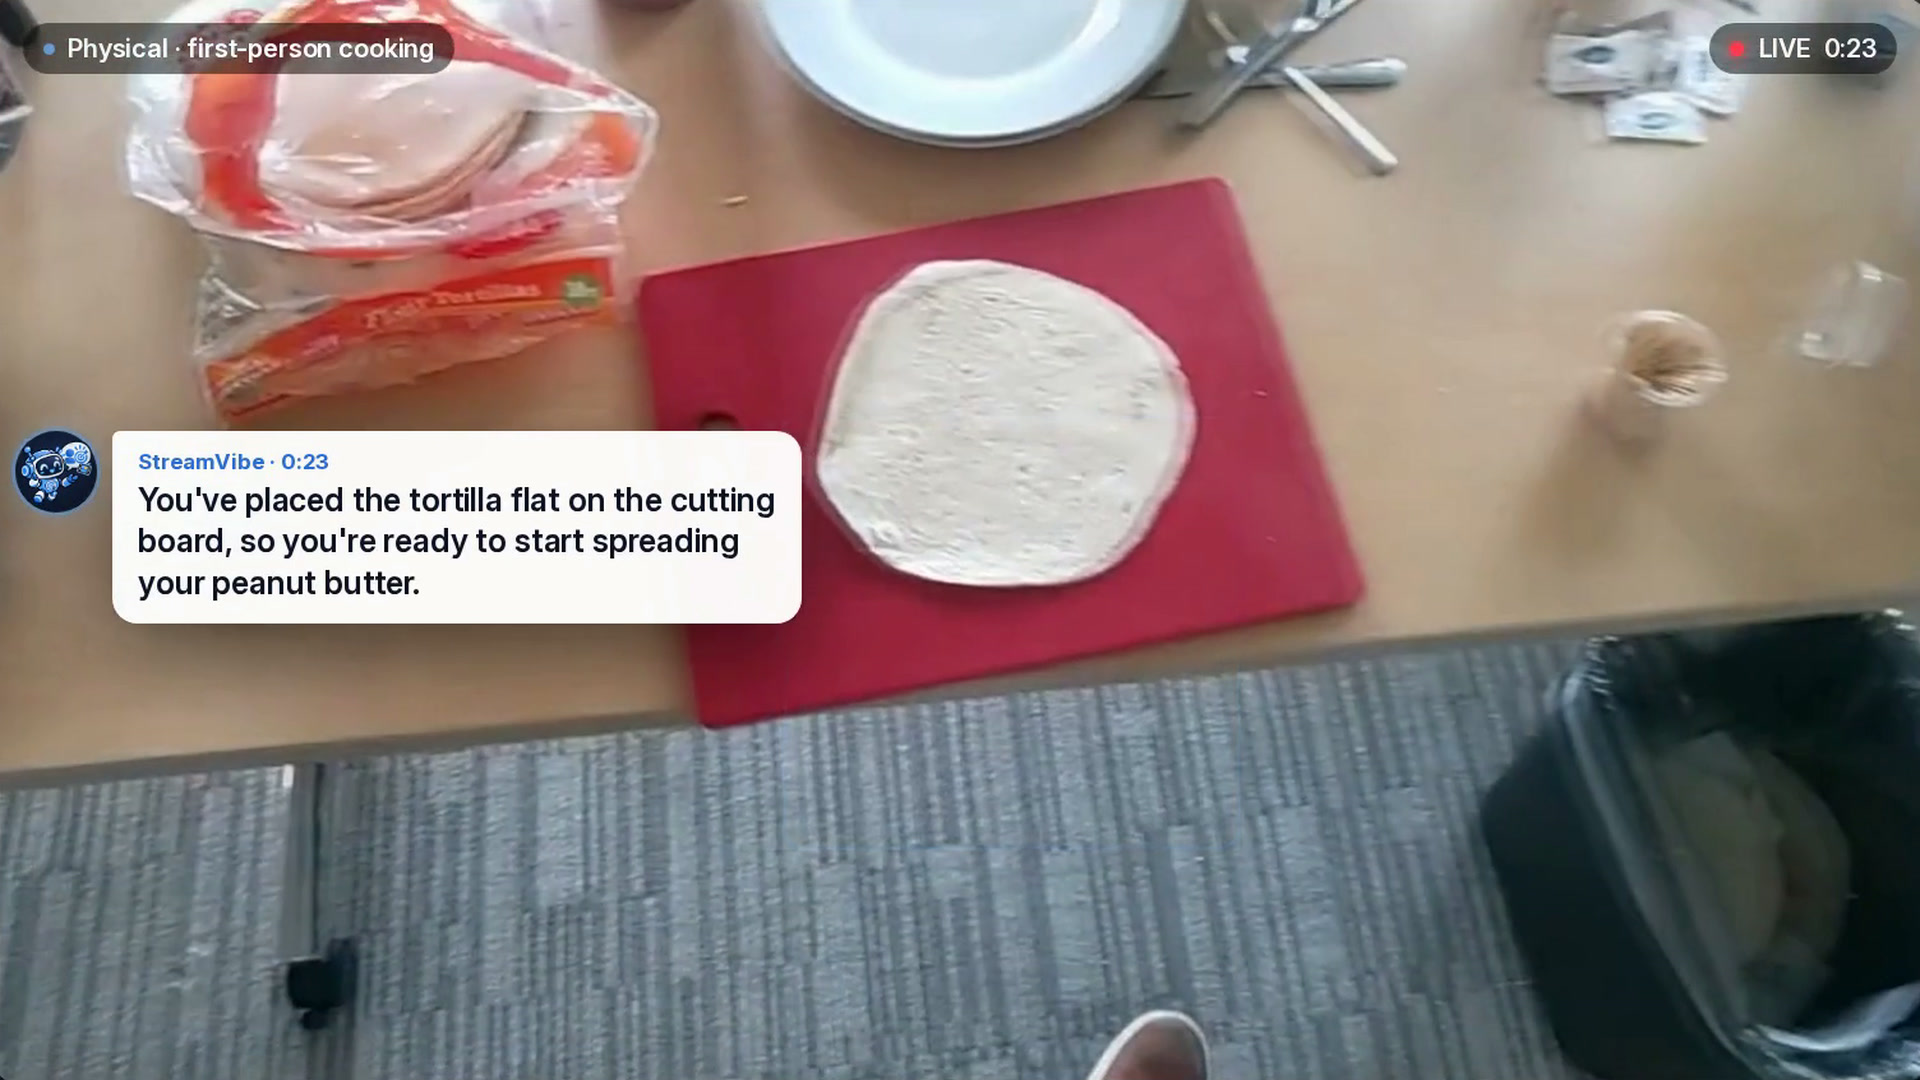
Nhóm nghiên cứu muốn xây một trợ lý có thể quan sát người dùng nấu ăn hoặc lắp đồ nội thất rồi chỉ lên tiếng khi thật cần. Với StreamVibe, họ tạo ra một video agent có thể hiểu cả những yêu cầu mơ hồ như “Hãy giúp tôi nếu tôi gặp khó khăn”.
Các video assistant hiện có thường được thiết kế cho những câu lệnh rõ ràng như “Hãy cho tôi biết khi nước bắt đầu sôi”, nên ít nhận ra ý định chưa nói ra. Chúng cũng khó theo dõi những gì đã làm xong, nên dễ lặp lại lời khuyên hoặc phản hồi quá muộn; khi người dùng đổi yêu cầu giữa chừng, chúng thường vẫn bám theo chỉ dẫn ban đầu.
Để đo vấn đề này, nhóm đã tổng hợp một bộ đo khoảng 4.100 ví dụ từ hơn 183 giờ ghi hình đời sống hằng ngày và phần mềm. Gemini 2.5 Flash gợi ý khi nào nên giúp và nên nói gì, còn 4 người đánh giá phải đồng ý nhất trí với mỗi ví dụ. Bộ đo chia thành 3 giai đoạn, gồm chỉ dẫn rõ ràng, mục tiêu mơ hồ và yêu cầu thay đổi theo thời gian.
Từ đó, các nhà nghiên cứu huấn luyện StreamVibe-VL, một model dường như dựa trên Qwen3.5-9B của Alibaba, để mỗi giây tự quyết định im lặng hay nói. Giai đoạn huấn luyện thứ hai dùng học tăng cường để model kiềm chế hơn, tránh ngắt lời liên tục.
Một hệ thống nhớ riêng theo dõi yêu cầu nào còn treo và bước nào đã xong, nhưng chính model vẫn tự quyết định có nói hay không và nói gì. Theo các nhà nghiên cứu, StreamVibe-VL cải thiện thời điểm phản hồi và chất lượng thêm 10,7% so với các model khác, còn hệ thống nhớ được thiết kế để tăng tương tác chủ động thêm 12,3% và giảm các lần ngắt lời không cần thiết.
Nhìn chung, StreamVibe-VL vượt model gốc của mình và các model mã nguồn mở khác với khoảng cách khá lớn, dù Gemini 3.8 Flash độc quyền của Google đạt điểm cao hơn trong một số phép thử. Theo tài liệu nghiên cứu, huấn luyện chuyên biệt này không làm giảm khả năng hiểu video nói chung.
Các model thường chọn đúng khi chỉ phải quyết định ở từng thời điểm cụ thể xem lời nhắc có phù hợp hay không. Nhưng khi chúng xử lý cả một video và phải dựa trên các phản hồi trước đó của chính mình, kết quả của tất cả hệ thống được thử đều giảm mạnh khi lỗi chồng lên nhau; một chỉ số nội dung quan trọng cho phản hồi giảm tới 61,5% dựa trên lịch sử của chính hệ thống. Với video dài hơn 5 phút, các model hiếm khi chọn đúng lúc và càng khó theo dõi một chỉ dẫn đã đổi trong quãng dài.
Nguồn
- Google wants video AI to understand what people need as they work— The Decoder, 1 tháng 11, 2026